Lo que hemos ido construyendo no empezó con la idea de darle más autonomía a un agente.
Empezó antes, cuando comenzamos a fortalecer la forma en la que trabajamos como equipo.
Empezamos por el proceso
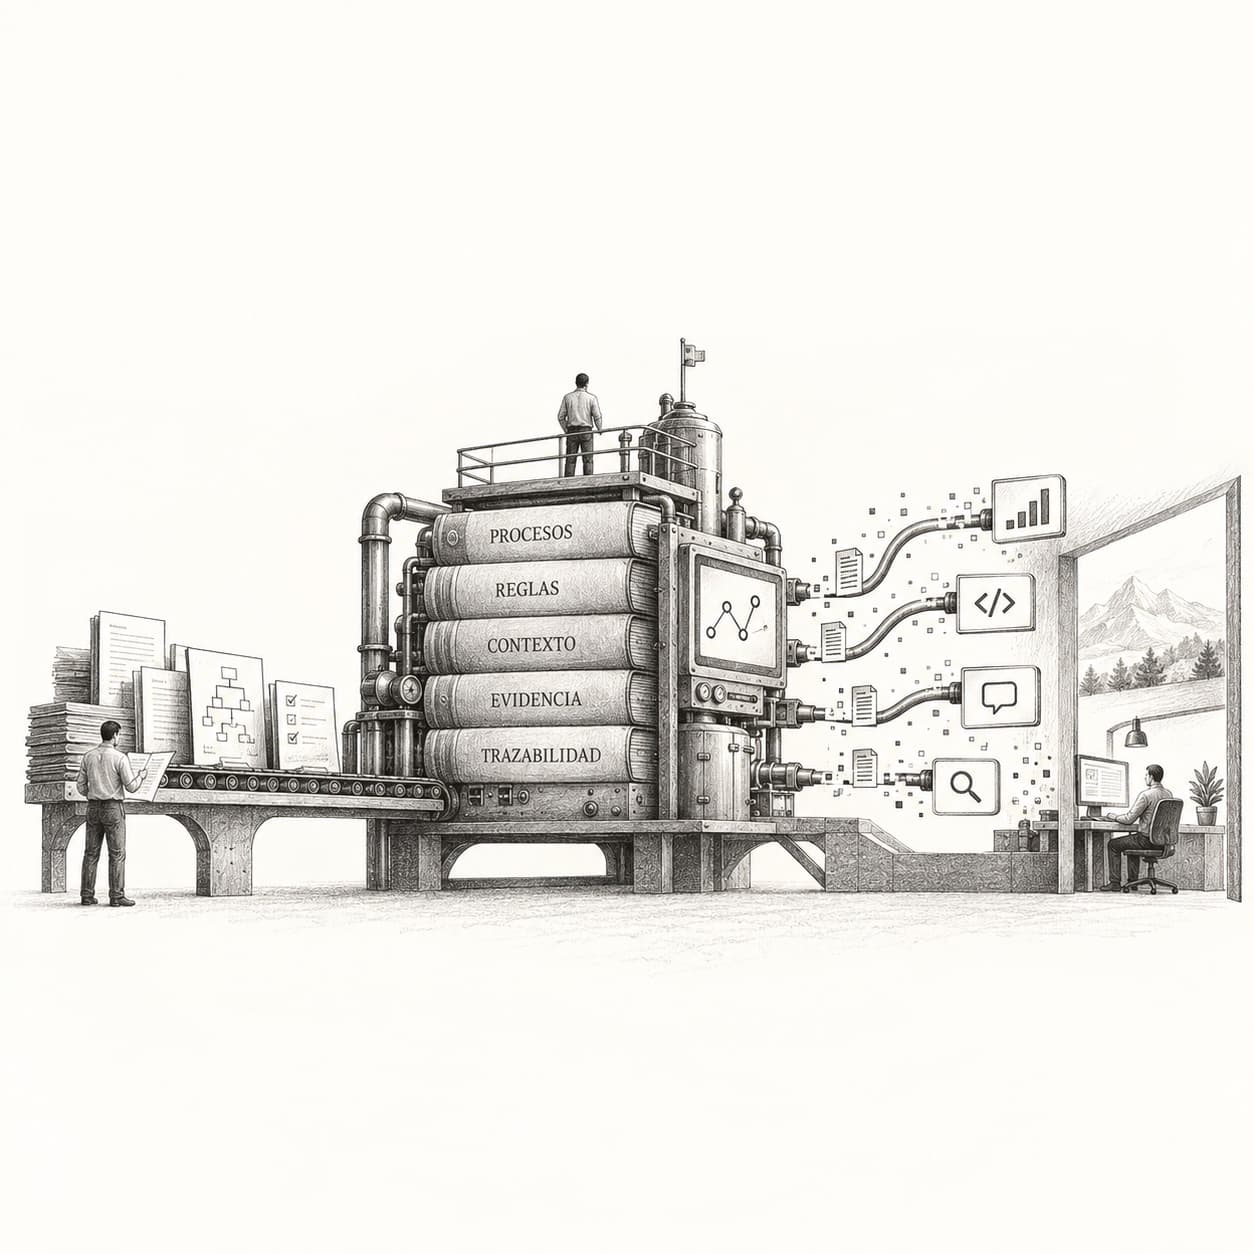
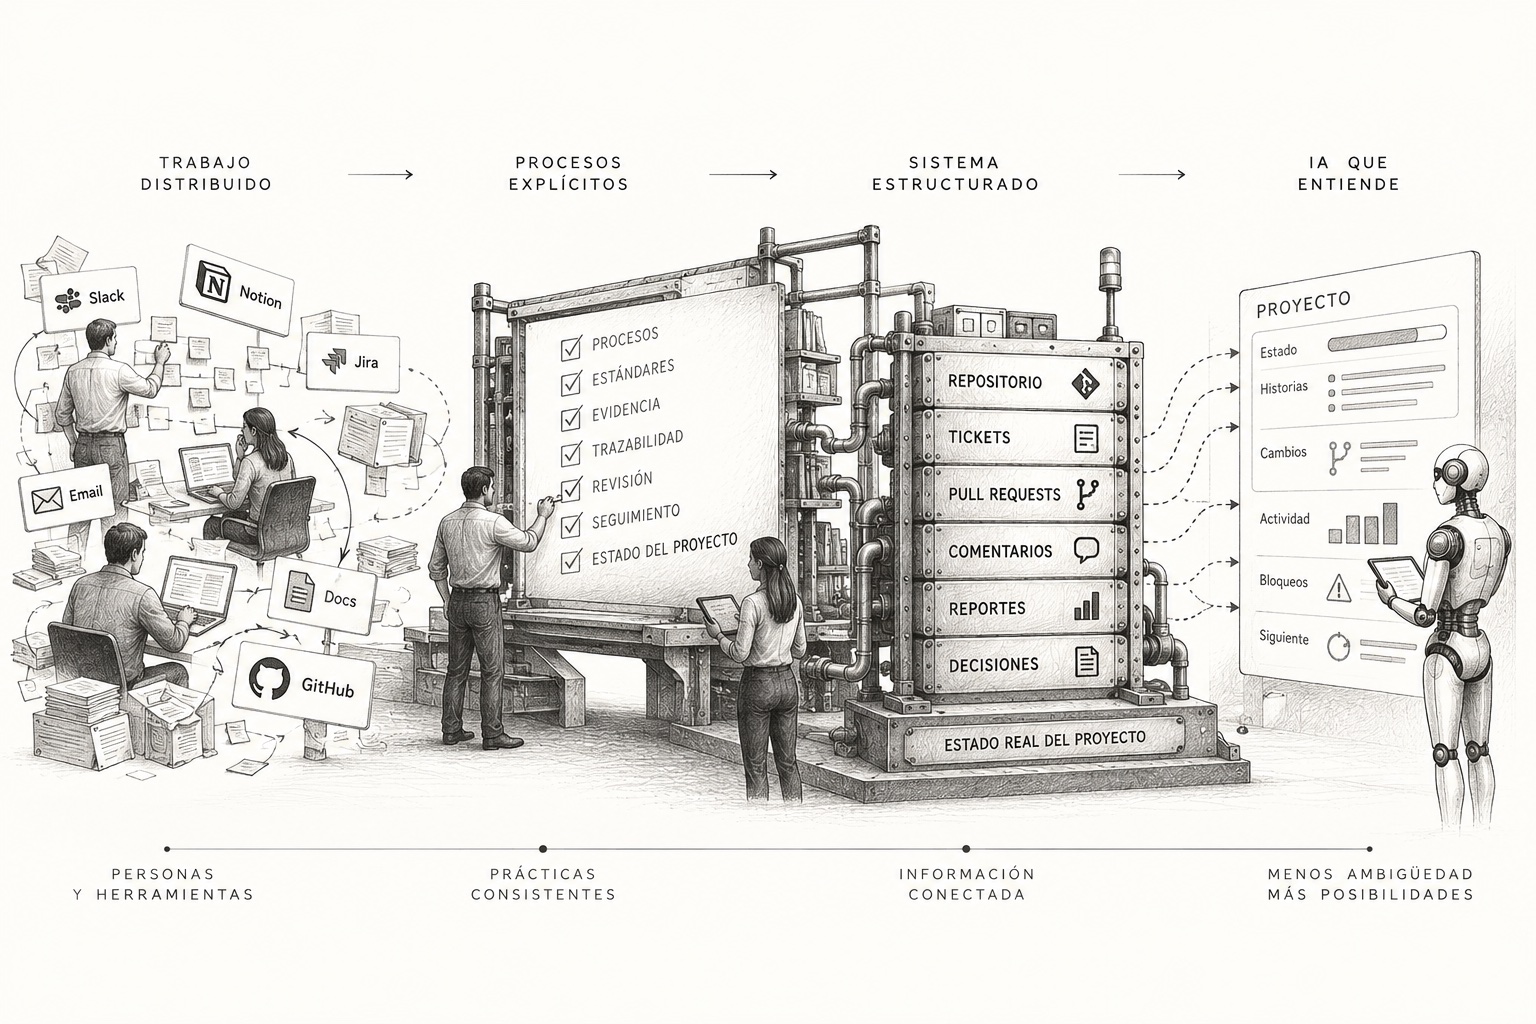
Fuimos haciendo más explícitos nuestros procesos, estandarizando cómo nos relacionamos con el trabajo, cómo dejamos evidencia, cómo conectamos una historia con un cambio, cómo revisamos, cómo damos seguimiento y cómo entendemos el estado real de un proyecto.
Muchas de esas prácticas ya existían, pero estaban distribuidas entre personas, herramientas y formas distintas de trabajar. Al hacerlas más consistentes y observables, también empezamos a reducir la ambigüedad del sistema.
La autonomía como consecuencia
Eso cambió nuestra relación con la IA.
Al principio, los agentes requerían mucha supervisión, instrucciones específicas y una transferencia constante de contexto. Pero conforme el entorno se volvió más estructurado, empezó a cambiar también el tipo de relación que podíamos tener con ellos.
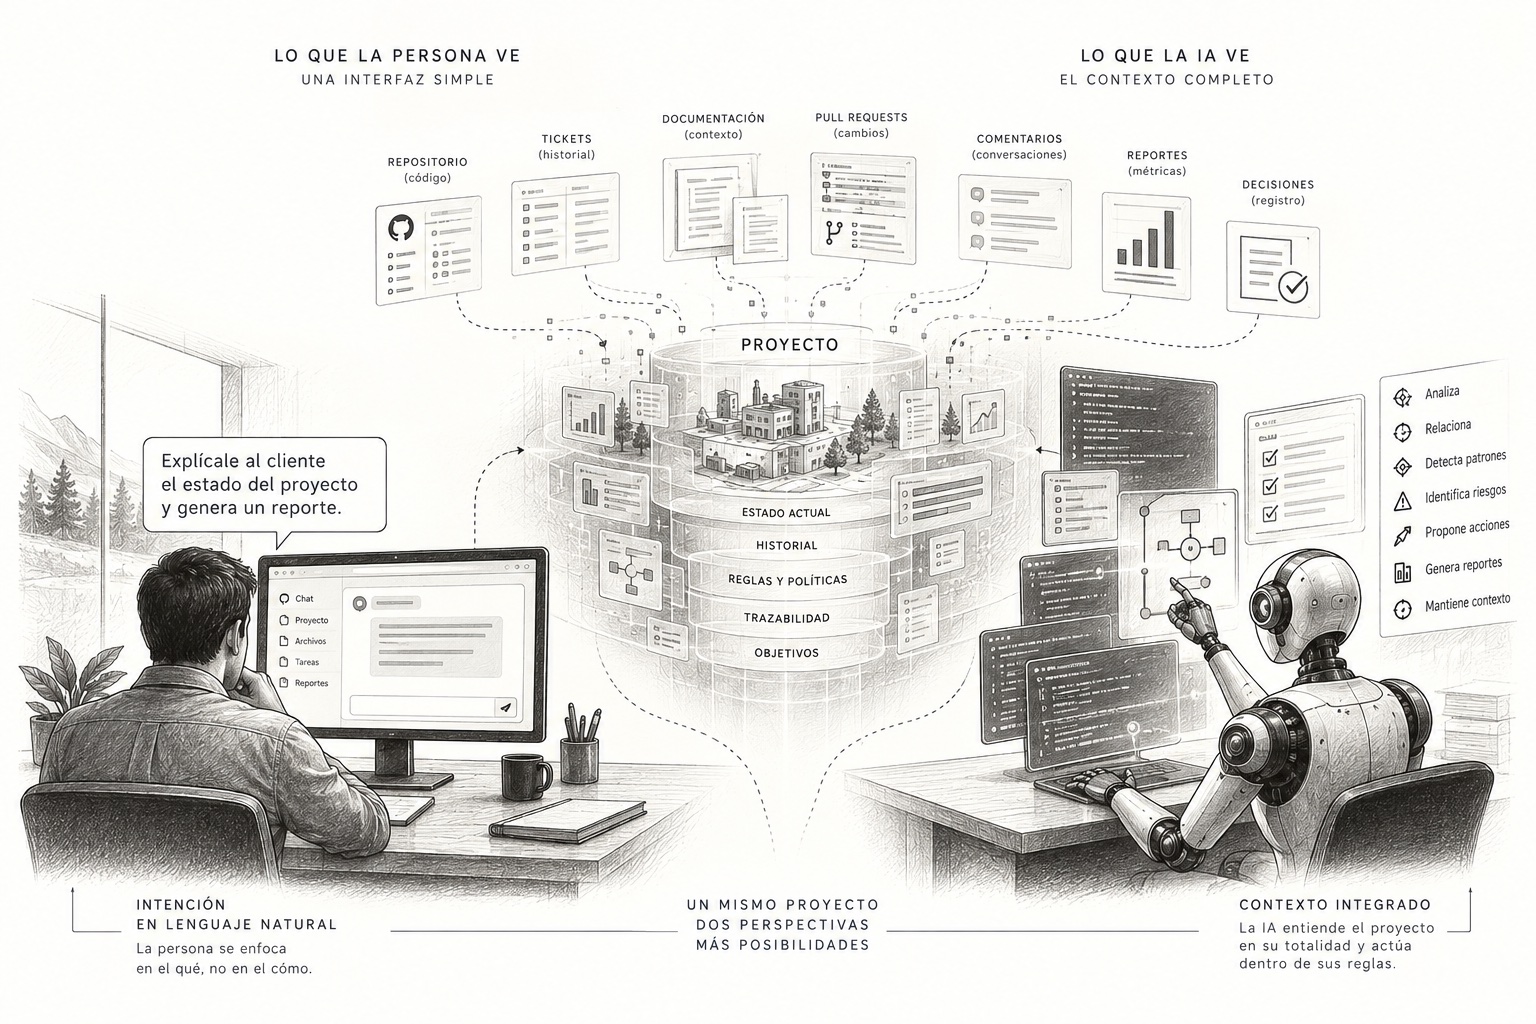
El agente ya no tenía que reconstruir todo desde cero. Podía entender mejor dónde estaba el estado del proyecto, qué reglas debía seguir, qué información consultar, qué acciones eran válidas y qué evidencia debía dejar.
La autonomía, entonces, no fue el punto de partida. Fue una consecuencia de haber fortalecido el sistema alrededor del agente.
La información como arquitectura continua
A medida que refinamos estos procesos, también empezamos a trabajar de otra forma con la información.
Dejamos de verla únicamente como algo que una persona consulta cuando lo necesita, y empezamos a tratarla como parte de una arquitectura continua.
El repositorio, los tickets, los PRs, los comentarios, los reportes y las decisiones ya no son únicamente registros aislados. Empiezan a formar una representación viva del estado del proyecto.
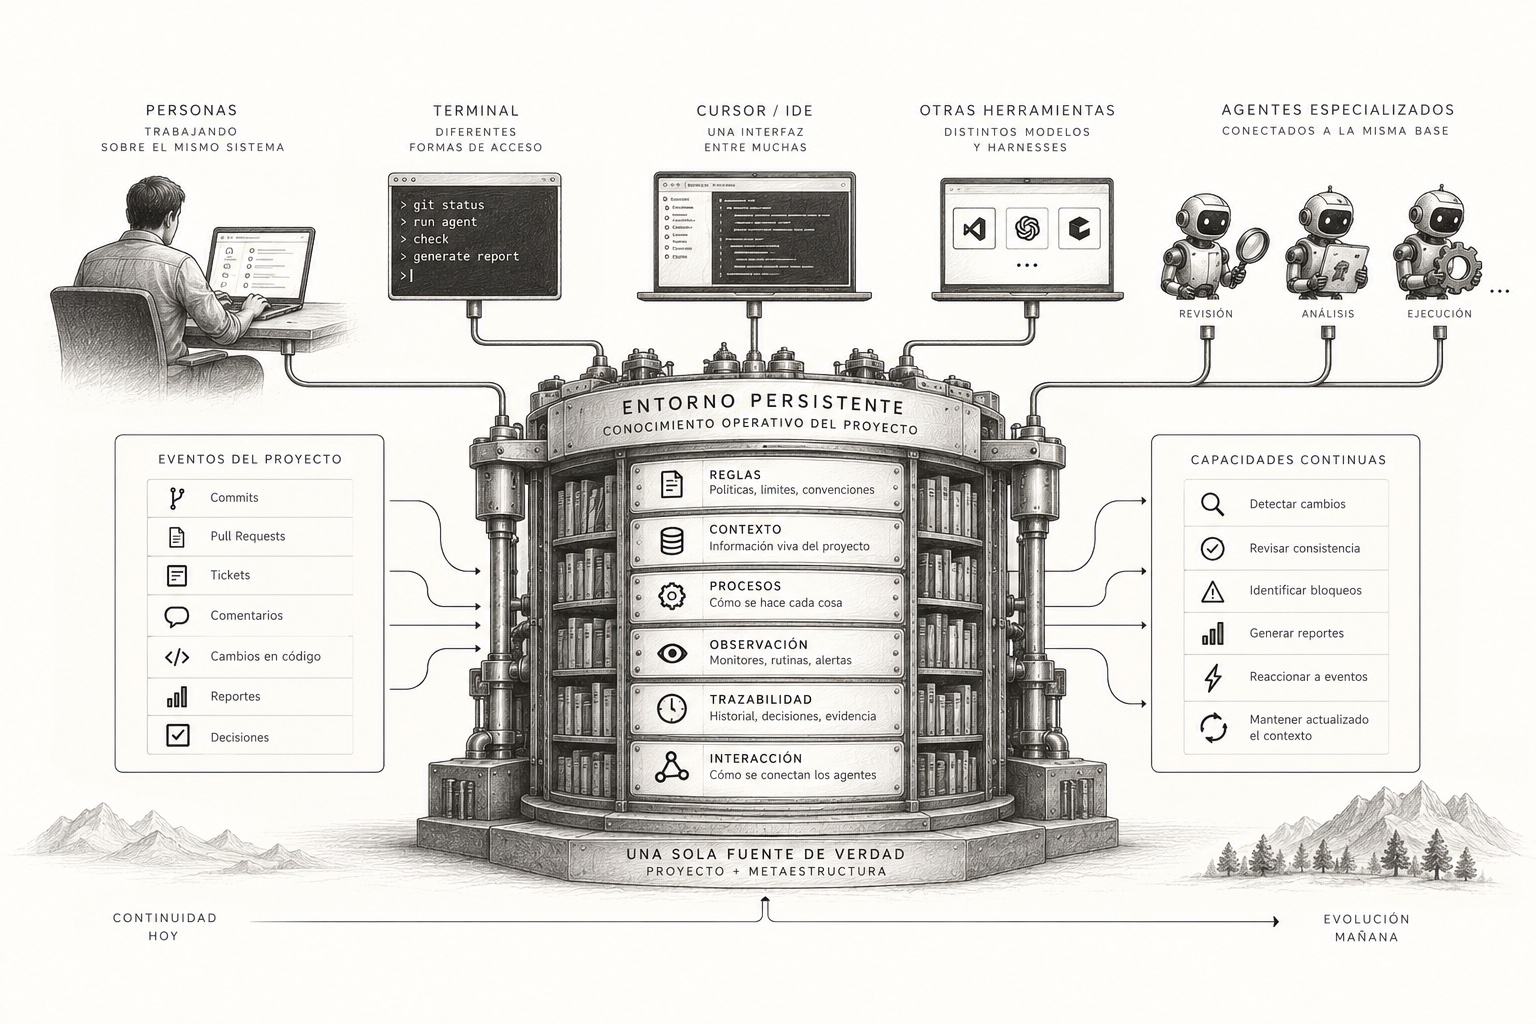
Sobre esa representación podemos construir monitores, rutinas, revisiones y agentes que observen continuamente lo que está ocurriendo. El sistema puede detectar cambios, revisar consistencia, identificar bloqueos, generar reportes o reaccionar ante ciertos eventos sin depender de que alguien vuelva a explicar todo el contexto.
Un entorno persistente
Esto nos lleva a una segunda etapa: consolidar ese conocimiento operativo dentro de un entorno persistente que mantenga actualizado el proyecto y la metaestructura que hemos ido construyendo alrededor de él.
Ese entorno no pretende convertirse en “el agente principal”. Su función es mantener continuidad. Ahí viven las reglas, el contexto, los procesos, los mecanismos de observación, la trazabilidad y las formas en las que un agente debe relacionarse con el proyecto.
A partir de ahí, distintas herramientas pueden conectarse sobre la misma base. Puede ser una terminal, Cursor, otro IDE, otro harness o distintos agentes especializados. La interfaz puede cambiar y el modelo puede cambiar, pero el proyecto mantiene su estructura y su forma de operación.
Una interfaz común
Ese es el punto que nos interesa consolidar.
No queremos que cada persona tenga que aprender cómo funciona por dentro todo el sistema agéntico para poder utilizarlo. Queremos encapsular ese conocimiento operativo y proyectarlo como una interfaz común sobre la cual humanos y agentes puedan trabajar.
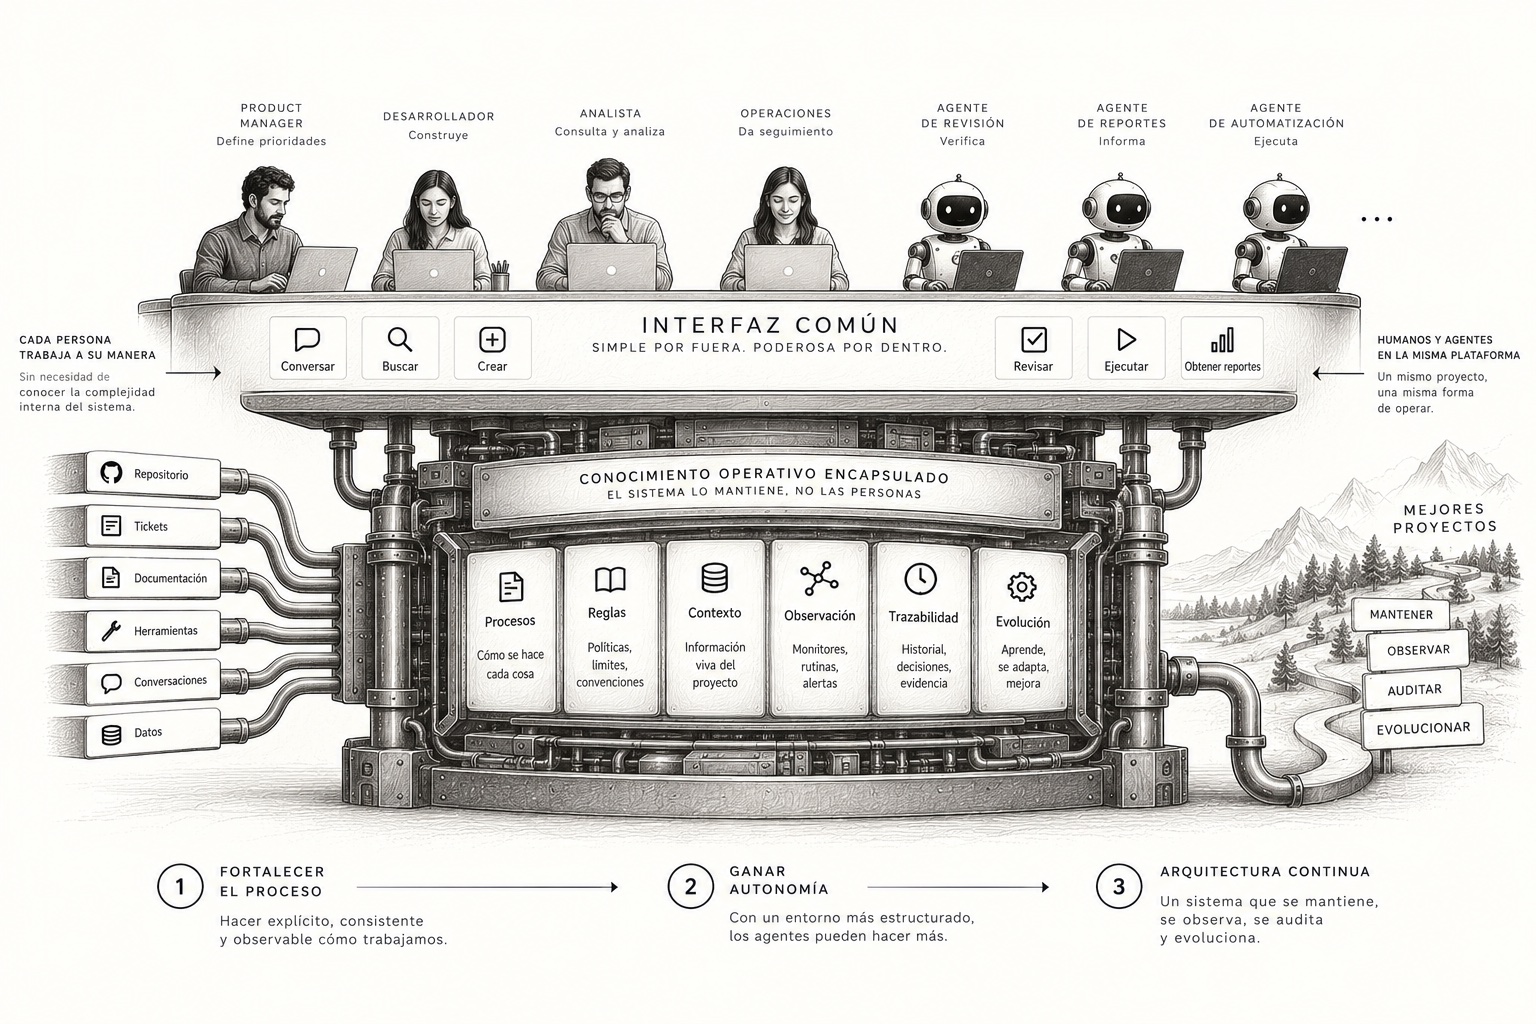
En vez de transferir constantemente el conocimiento de cómo operar el sistema, buscamos que ese conocimiento forme parte del propio sistema.
Primero el proceso, después la autonomía
Ese es nuestro enfoque de integración con IA: primero fortalecer el proceso, después ganar autonomía, y finalmente convertir ese aprendizaje en una arquitectura continua que pueda mantenerse, observarse, auditarse y evolucionar.